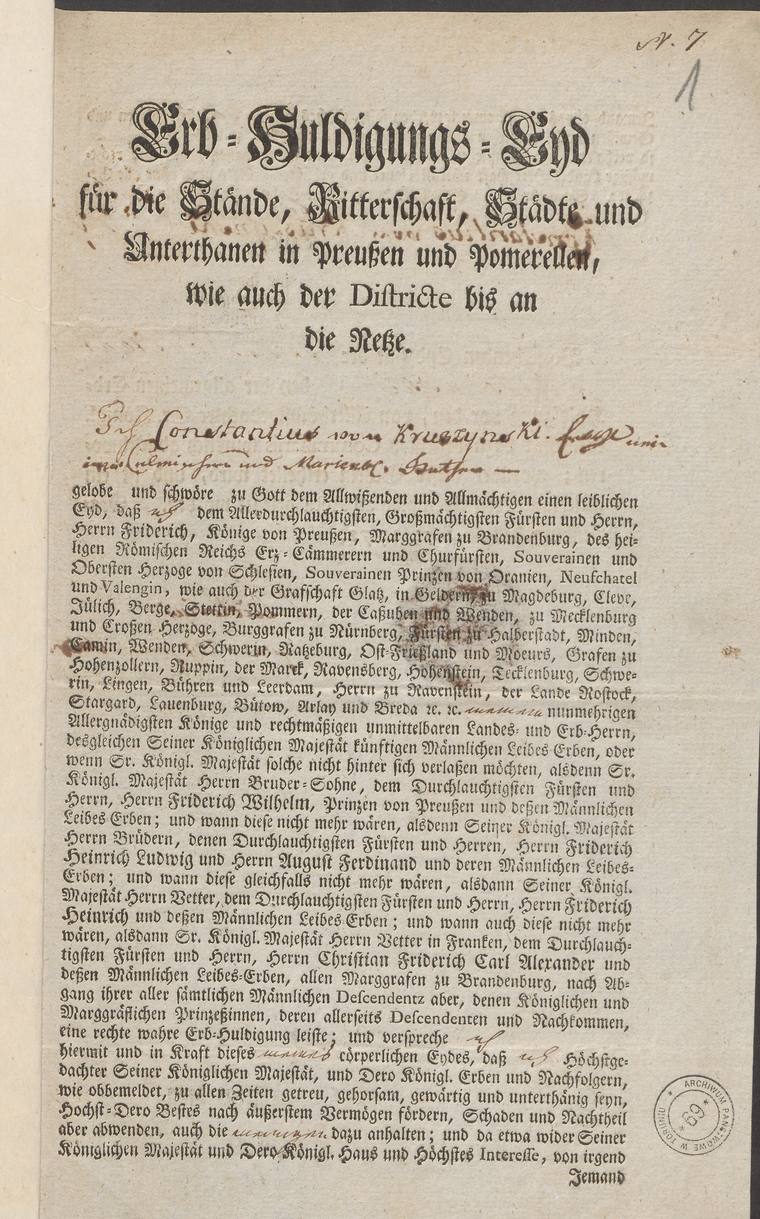
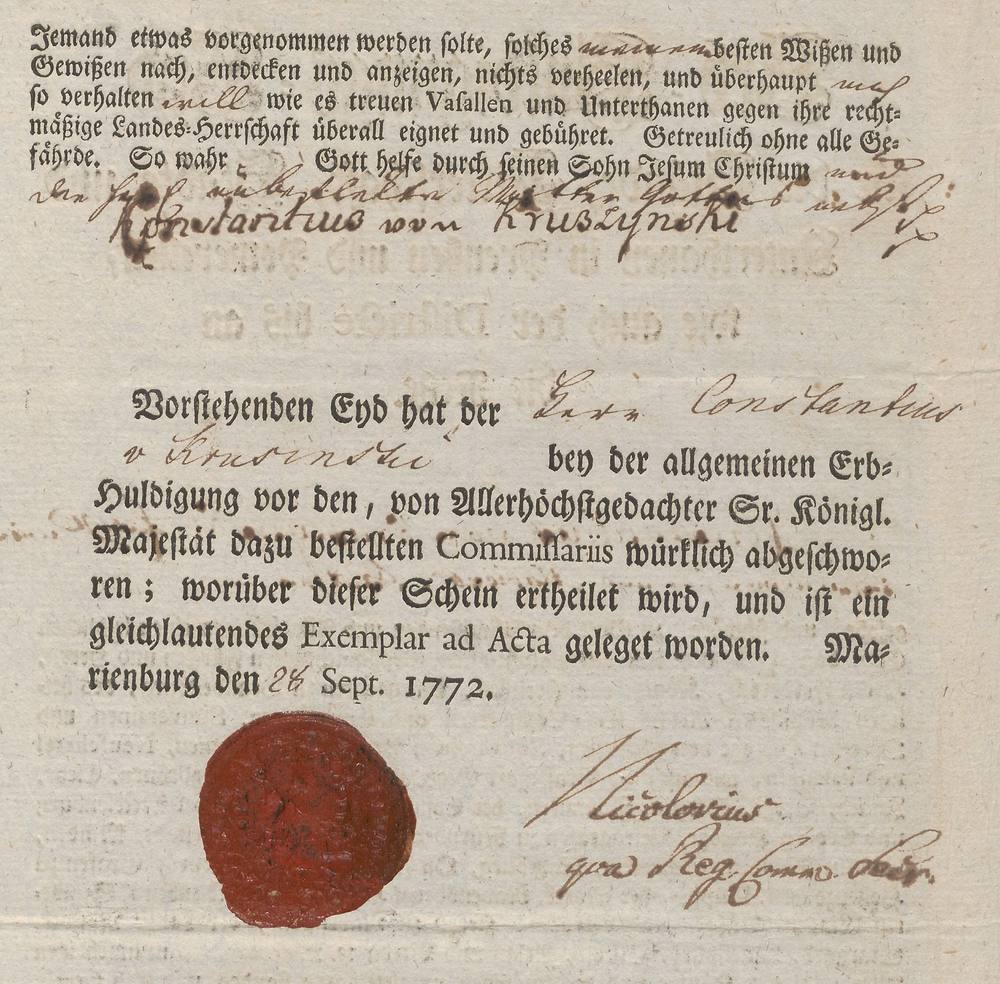
odczyt modelu, fragmentIch Constantinus von Kruszynski, Freyherr
in der Culmischen und Marienb. Stattfen —
…
Konstantius von Kruszynski

Vorstehenden Eyd hat der [dopisek: Herr Constantius
v Kruszinski] bey der allgemeinen Erb=
Huldigung … würklich abgeschwo=
ren; … Ma=
rienburg den 28 Sept. 1772.

Nicolovius
pra Reg. Commissar.
1. Opis zespołu
Archiwum Sczanieckich z Nawry jest zespołem rodzinno-majątkowym z ziemi chełmińskiej, obejmującym 607 jednostek i 60 197 skanów z lat 1459–1981 w czterech językach. Do analizy wybrano z niego zwarty fragment: trzynaście jednostek serii 7.2, dokumentujących działalność publiczną jednej osoby, Konstantego Kruszyńskiego z Nawry.
Kariera Kruszyńskiego obejmuje trzy porządki polityczne. W 1772 roku składa on przysięgę hołdowniczą królowi pruskiemu, w 1777 roku uczestniczy w sejmie w Królewcu, a w 1807 roku, już w Księstwie Warszawskim, obejmuje funkcję prezesa Deputacji Administracyjnej w Toruniu; następnie jest radcą departamentu bydgoskiego, marszałkiem sejmiku, członkiem komisji podatkowej i dozoru szkolnego. Akta sporządzono w związku z tym w językach polskim, niemieckim, łacińskim i francuskim. Obejmują one rękopisy kancelaryjne, teksty pisane kurrentą, druki urzędowe, tabele składek i koperty z pieczęciami.
Z tych samych względów materiał ten nadaje się do weryfikacji metody. Jeden twórca i jeden region tworzą sieć osób, która się zagęszcza, zamiast rozpadać na odrębne skupiska. Zróżnicowanie pism i typów dokumentów pozwala ocenić model jednocześnie we wszystkich zadaniach. Opisy archiwisty w inwentarzu stanowią punkt odniesienia dla datowania i streszczeń.
| Sygn. | Zawartość wg inwentarza | Skany | Rozbieżność odczytów* |
|---|---|---|---|
| 459 | działalność publiczna 1776–1812, akcyza i cło (sprowadzanie wódki) | 95 | 9,8% |
| 460 | Erb-Huldigungs-Eyd 1772 | 12 | 4,8% |
| 461 | list dziękczynny franciszkanów 1814 | 6 | — |
| 462 | sejm w Królewcu 1777 | 64 | 10,3% |
| 463 | Acta Commissionis, kamera w Kwidzynie 1806 | 102 | 11,3% |
| 464 | prezes Deputacji Administracyjnej Toruńskiej 1807–1808 | 296 | 10,5% |
| 465 | marszałek sejmiku toruńskiego 1808 | 24 | 1,9% |
| 466 | radca departamentu bydgoskiego 1808–1810 | 64 | 9,1% |
| 467 | konsyliarz kredytu ziemskiego 1808–1811 | 56 | 7,1% |
| 468 | komisja porównania podatków, Dep. Bydgoski 1808–1811 | 128 | 10,6% |
| 469 | długi kamlarii toruńskiej 1811 | 38 | 14,1% |
| 470 | dozór szkolny 1813 | 46 | 10,9% |
| 471 | komisja włościańska 1814 | 42 | 2,3% |
| razem | 973 | 10,0% |
* Mediana rozbieżności słów między dwoma niezależnymi odczytami; strony zawierające co najmniej 50 słów (530 stron). Wartość ta nie jest odsetkiem błędów (zob. rozdz. 5).
2. Metoda
Przebieg przetwarzania obejmuje dziesięć etapów. Obraz jest przekazywany modelowi tylko w jednym z nich, w etapie odczytu. Pozostałe etapy operują na tekście albo są realizowane przez deterministyczny kod. Dzięki temu każdy wynik jest powtarzalny, a koszt zależy niemal wyłącznie od jednego etapu.
- 01Pobranie skanówSerwis archiwalny jest chroniony zabezpieczeniem przed automatycznym pobieraniem. Pobieranie jest możliwe wyłącznie przez przeglądarkę bezgłową, 0,3–0,5 s na plik. Rozdzielczość wersji pełnej: ok. 2200 × 3500 px.kod
- 02Odrzucenie pustych stronPomiar „gęstości atramentu” na miniaturach. 301 z 973 skanów (31%) to odwrocia, puste karty i obwoluty; nie są one przekazywane modelowi.kod
- 03Usunięcie znaku wodnegoPasek z napisem „Archiwum Państwowe w Toruniu” zajmuje ok. 8% wysokości skanu. Pozostawiony, zostałby przez model transkrybowany.kod
- 04Dwa niezależne odczytyTen sam prompt i ta sama strona w dwóch wywołaniach. Wynik w formacie JSON: regiony z ramkami, transkrypcja dyplomatyczna, transkrypcja znormalizowana, przekład na język polski, streszczenie, niepewne odczyty z wariantami, typ strony, język, rodzaj pisma, foliacja.model, obraz
- 05Porównanie odczytówCER i rozbieżność słów r1↔r2 dla każdej strony i regionu. Wobec braku transkrypcji wzorcowej (gold standard) wynikiem jest mapa niepewności.kod
- 06Graf wiedzyEkstrakcja z tekstu, bez obrazu: osoby, miejsca, urzędy, instytucje, kwoty, wydarzenia; relacje z cytatem, datą, regionem i jednym z czterech stopni pewności.model, tekst
- 07Łączenie encjiScalenie 6 760 wzmianek w 3 108 bytów. Model otrzymuje porcje wariantów nazw wraz z kontekstem i rozstrzyga, które z nich odnoszą się do tej samej osoby.model, tekst
- 08Lokalizacja miejscowościBez udziału modelu: PRNG (GUGiK) i Wikidata; zgodność obu źródeł w promieniu 3 km oznacza identyfikację pewną.kod
- 09SłownikiJedno wywołanie na słownik: 98 rodzajów dokumentów → 14 kategorii; 445 nazw urzędów → formy kanoniczne i grupy.model, jednorazowo
- 10Dane pochodneBez udziału modelu: granice dokumentów, datowanie przybliżone na podstawie dokumentów sąsiednich, miejsce wystawienia i adresat, przeliczenie kwot na złote.kod
2.1. Założenia metodyczne
- Dwa odczyty bez etapu rozstrzygania. Brak stron poprawionych ręcznie uniemożliwia obecnie obliczenie rzeczywistego błędu. Dwa niezależne odczyty pozwalają wskazać miejsca, w których wynik modelu jest niepewny. Dodatkowy etap, w którym model rozstrzyga między odczytami, kosztowałby ok. $10; jego realizację odłożono.
- Najwyższa rozdzielczość obrazu. W modelach Gemini obraz kosztuje stałą liczbę tokenów niezależnie od wymiarów. Strona w trybie
ultra_highto ok. 2 210 tokenów obrazu i 650 tokenów instrukcji. W przypadku rękopisów poprawa jakości uzasadnia dwukrotnie wyższy koszt wejścia, a w koszcie całkowitym i tak przeważa koszt wyjścia. - Segmentacja na regiony, nie na wiersze. Model zwraca prostokątne ramki regionów (nagłówek, tekst główny, tabela, podpis, pieczęć, adres, notatka, foliacja) w skali 0–1000. Wystarcza to do odsyłaczy do określonego fragmentu skanu i do mapy niepewności. Synchronizacja tekstu ze skanem wiersz po wierszu wymagałaby odrębnej segmentacji.
- Cztery warstwy tekstu. Transkrypcja dyplomatyczna zachowuje pisownię, podziały wierszy i skróty („Oyczyzna”, „Woyny”, „X” jako skrót słowa „ksiądz”). Transkrypcja znormalizowana służy wyszukiwaniu. Przekład na współczesny język polski jest zrozumiały bez znajomości niemieckiego i łaciny. Streszczenie opisuje dokument.
- Rozdzielenie ekstrakcji grafu od odczytu. Ekstrakcja encji operuje na tekście, nie na obrazie. Jest tańsza i nie uruchamia filtra bezpieczeństwa, który blokował część odczytów (zob. rozdz. 3.2). Każda relacja zawiera cytat ze źródła, numer strony i region.
- Czterostopniowa skala pewności. „Z tekstu” (informacja zapisana wprost), „pewna”, „prawdopodobna”, „z kontekstu” (wywnioskowana). Najwyższy stopień ma 3 621 z 3 841 relacji. Identyfikacje kontekstowe oznaczono odrębnie.
- Proweniencja każdego odczytu. Rejestrowane są: model, wersja promptu, poziom rozumowania, rozdzielczość, skrót SHA-256 obrazu, tryb wywołania (wsadowy, interaktywny, awaryjny) i liczba tokenów. Wynik można odtworzyć i porównać z kolejnym przebiegiem.
- Deterministyczne obliczenia wykonywane kodem. Wszystkie operacje, które można zrealizować kodem, są realizowane kodem: identyfikacja miejscowości, datowanie przybliżone, przeliczanie walut i wyznaczanie granic dokumentów. Model nie szacuje współrzędnych.
3. Przykłady odczytów
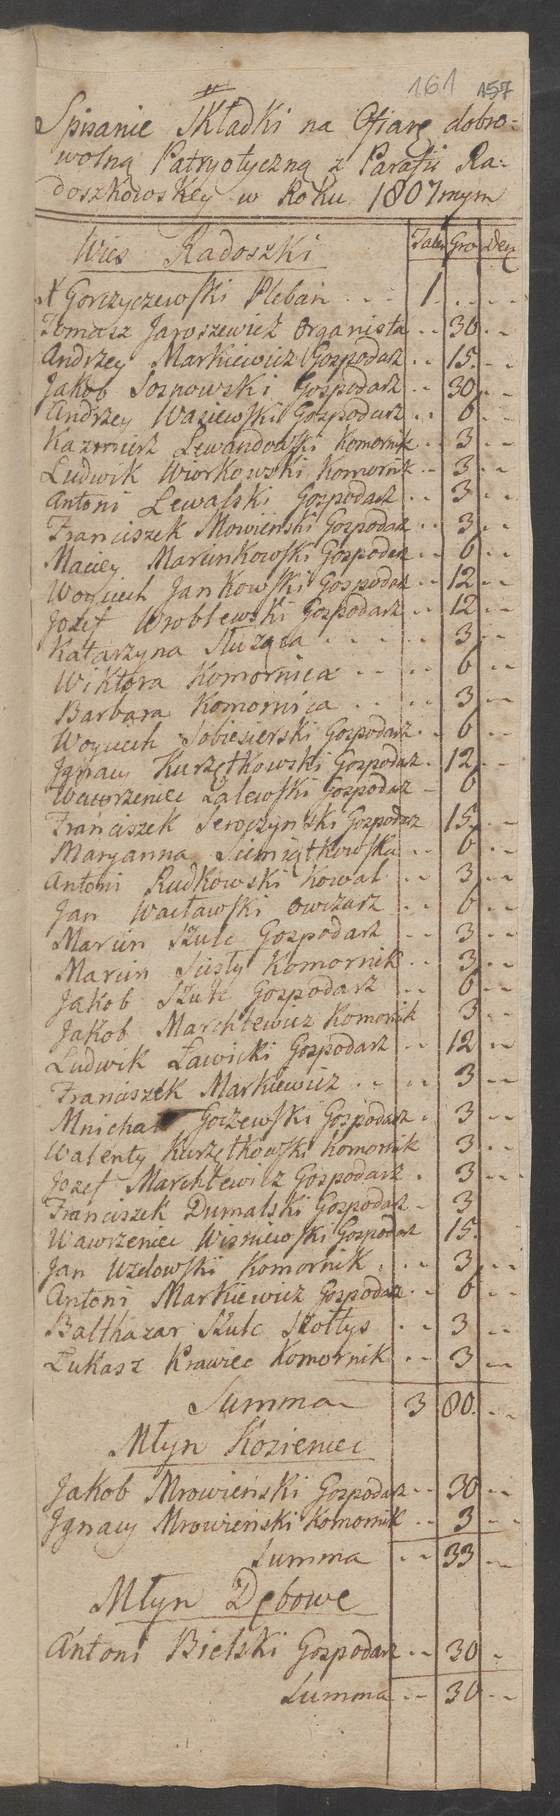
3.1. Spis składki patriotycznej, parafia Radoszki, 1807
Tabela z 1807 roku wymienia mieszkańców wsi Radoszki i dwóch młynów, ich stan (gospodarz, komornik, owczarz, kowal, sołtys, służąca) oraz datek na „Ofiarę dobrowolną Patryotyczną” w talarach i groszach. Jednostka 464 zawiera ponad dwadzieścia takich spisów; pochodzi z nich większość spośród 372 krawędzi typu „płaci” w grafie.
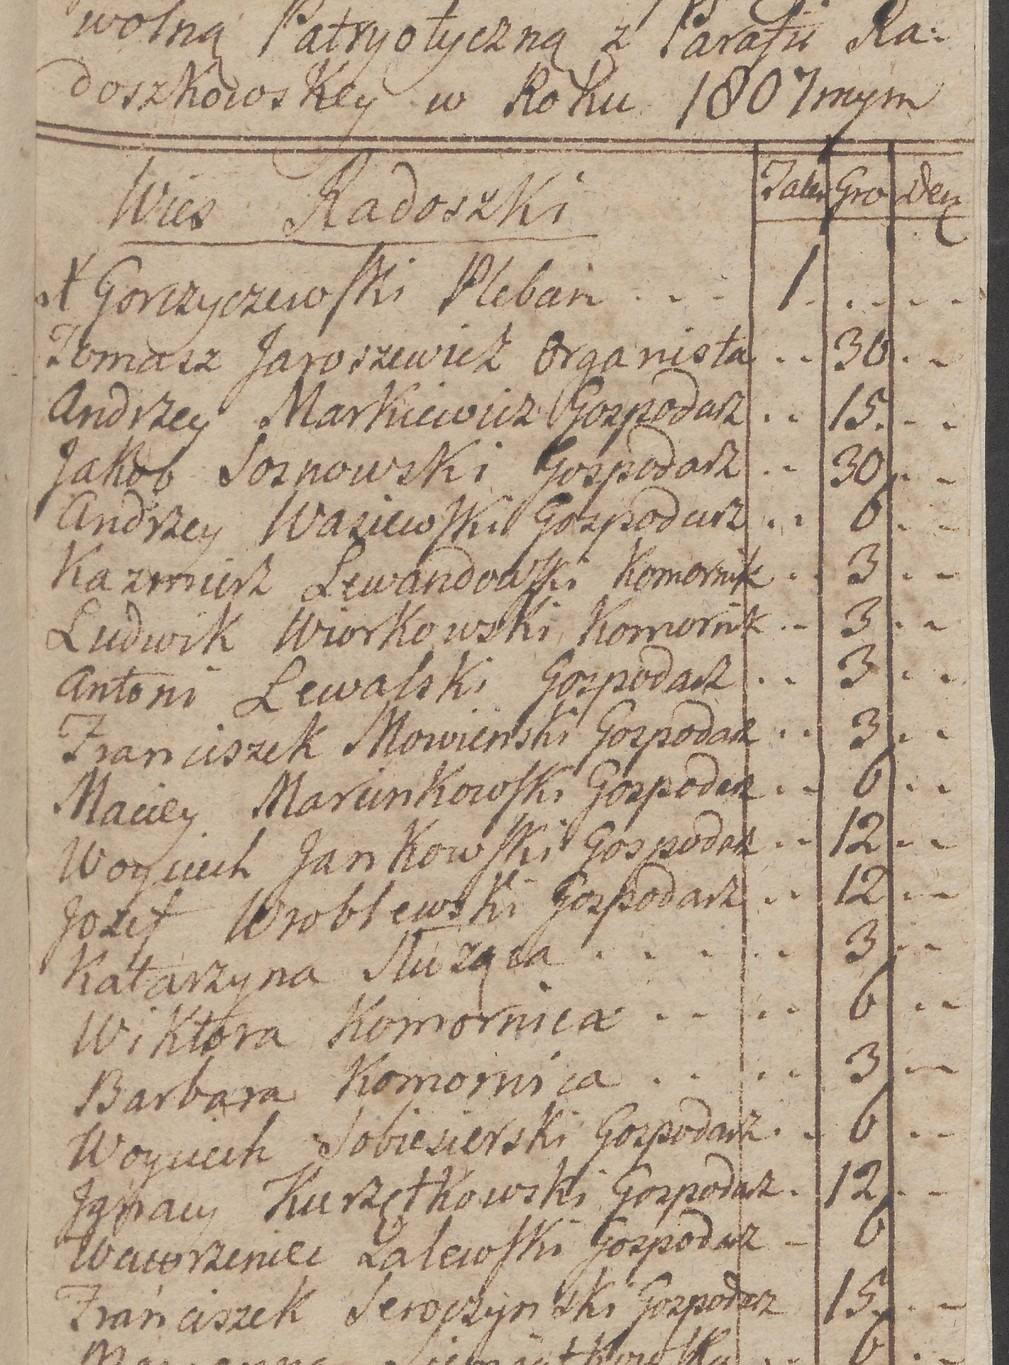
| Odczyt 1 | Odczyt 2 | Komentarz |
|---|---|---|
| Ks Gorzyczewski | X Gorzyczewski | „X” to dawny skrót słowa „ksiądz”; drugi odczyt jest wierniejszy. |
| Maciey Marunkowski | Maciey Marcinkowski | nazwisko wymagające weryfikacji |
| Jgnacy Kuszętkowski | Ignacy Kurzętkowski | niepewność: „sz” lub „rz” |
| Marcin Justy komornik | Marcin Szulc komornik | różne osoby; drugi odczyt powtarza nazwisko z wiersza powyżej |
| Mnichał Gorzewski | Michał Gorzewski | pierwszy odczyt odnotowuje plamę atramentu przy imieniu |
| - | 30 | - | | . | 30. | . . | puste komórki: kreska lub kropki; kilkadziesiąt takich różnic na stronie |
3.2. Akta akcyzowe w kurrencie niemieckiej, 1776
Jednostka 459 zawiera protokół przesłuchania w sprawie wódki przewożonej przez kasztelana Kruszyńskiego do jego karczmy w Nawrze bez zgłoszenia w urzędzie akcyzowym. Tekst zapisano kurrentą niemiecką, z wtrąceniami łacińskimi (Quaest., Resp.) i dopiskami.
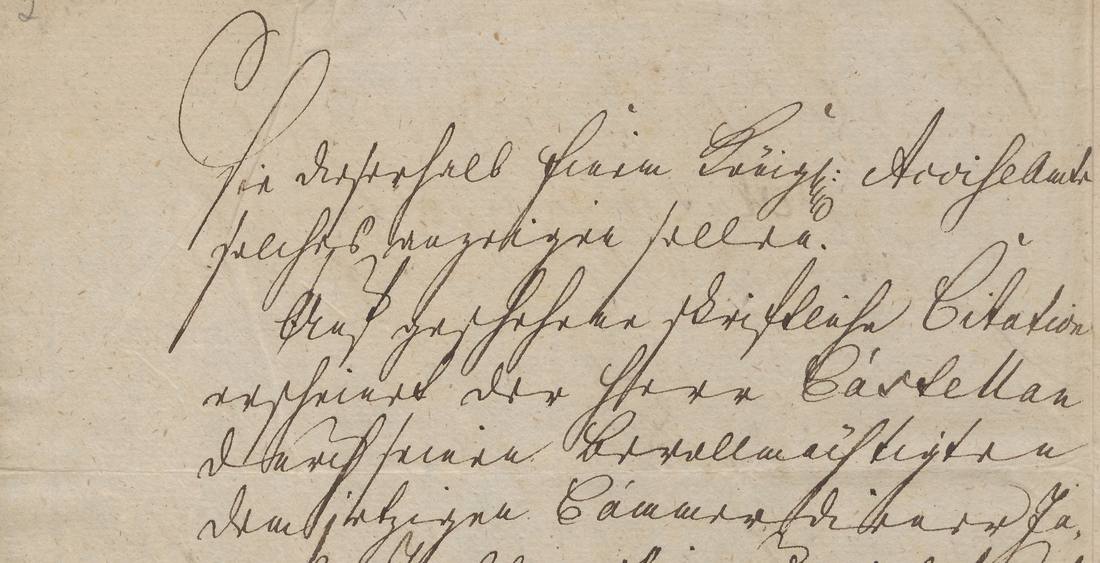
odczyt 1Nach geschehener schriftliche Citation
erscheinet der Herr Castellan
d' Krussinski Bevollmächtigte u
dambstätische Cammerfiscalis Ja-
cob Jablonski und giebet nach
gethanen Frageln Folgendes
zu Antwort:
$\underline{\text{Quaest:}}$ Ob dem Herrn Castellan …
odczyt 2 (tryb awaryjny, 7 prób)Nach geschehener schriftlicher Citation
erscheinet der Herr Castellan
und vorscheinende Bevollmächtigter u.
demtselbigen Cämmerer Justitiarius Ja-
cob Jablonskij und gibet nach
gethanen Fragen folgendes
zur Antwort:
Na tej stronie po raz pierwszy zaobserwowano działanie filtra bezpieczeństwa Gemini. Odpowiedź HTTP 200 nie zawierała treści, a jedynie pole blockReason: OTHER. Testy wykazały, że blokadę wywołuje żądanie tekstu transkrypcji w formie ustrukturyzowanej (schemat JSON z polem tekstowym). Metadane i ramki regionów bez tekstu nie są blokowane, a standardowa odpowiedź tekstowa jest przepuszczana niemal zawsze. Wzmianka o wódce w tytule jednostki nie miała wpływu na blokady. Ich odsetek zwiększało natomiast słowo „przebijający (tekst)” w instrukcji; zastąpiono je sformułowaniem „prześwitujący z odwrocia”.
W przebiegu zastosowano w związku z tym kaskadę: trzy próby ze schematem, dwie z formatem JSON opisanym w instrukcji, a na końcu tryb dzielony, w którym tekst oraz metadane z ramkami są pobierane w osobnych wywołaniach. W całym zbiorze filtr zablokował 91 z 1 344 odczytów (6,8%), również na stronach polskich. Po zastosowaniu kaskady 19 stron (2,8%) odczytano w trybie awaryjnym. Jedna strona ma tylko jeden odczyt.
3.3. Podpisy deputatów, 1808–1811
Memoriał deputatów departamentu bydgoskiego w sprawie trzyletniego moratorium podpisuje kilkunastu delegatów powiatów. W pierwszym odczycie jeden z podpisów brzmi „Kruszyński Deputat Powiatu Chełmińskiego”, w drugim „Gruszczyński”.
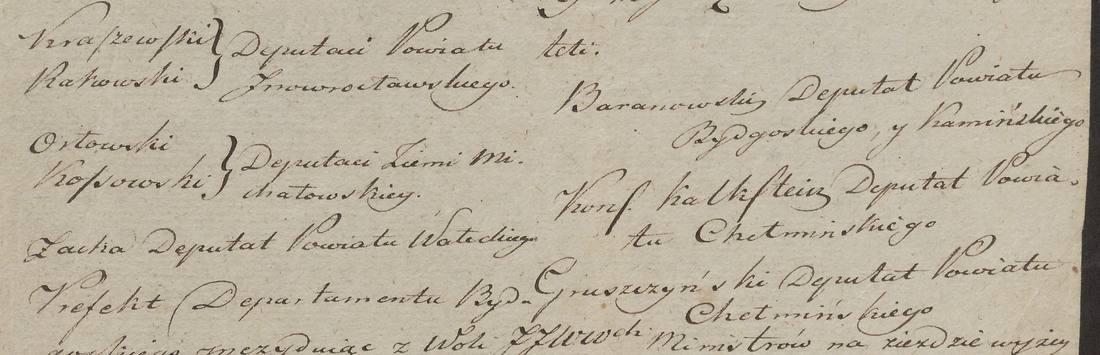
3.4. Odezwa w sprawie ofiar na rzecz Ojczyzny, 1807
Dokument dotyczy tej samej zbiórki co spis z Radoszek, lecz z perspektywy jej organizatora. Jest to brudnopis odezwy do właścicieli dóbr ziemi michałowskiej, z dopiskiem kancelaryjnym i skróconym podpisem „Krusz”.
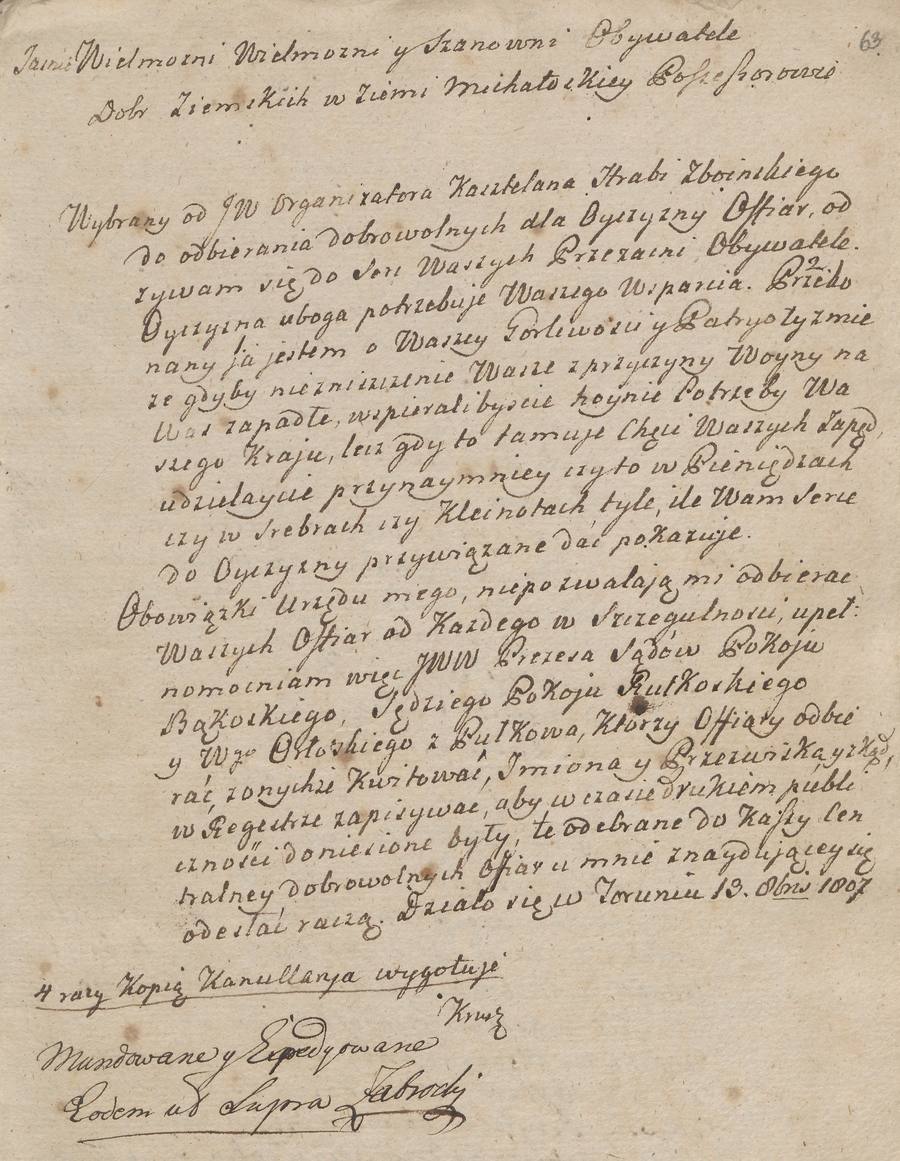
transkrypcja dyplomatycznaWybrany od JW Organizatora Kasztelana Hrabiego Zboińskiego
do odbierania dobrowolnych dla Oyczyzny Offiar, od-
zywam się do Serc Waszych Przezacni Obywatele.
Oyczyzna uboga potrzebuje Waszego Wsparcia. Przeko-
nany ja jestem o Waszey Gorliwosci y Patryotyzmie
ze gdyby niezniszczenie Wasze z przyczyny Woyny na
Was zapadłe, wspieralibyscie hoynie Potrzeby Wa-
szego Kraju …

4 razy Kopią Kancellarya wygotuje
Krusz
Streszczenie modelu: odezwa (zapewne Konstantego Kruszyńskiego) do obywateli i posesorów dóbr ziemskich w ziemi michałowskiej z apelem o dobrowolne ofiary na rzecz ubogiej Ojczyzny, w pieniądzach, srebrze lub klejnotach. Z powodu nawału obowiązków autor upoważnia prezesa sądu pokoju Bąkowskiego…
4. Struktura zbioru: dane ilościowe
Dokumenty według roku
186 dokumentów z datą zapisaną w tekście (słupki pełne) i 113 datowanych w przybliżeniu na podstawie sąsiednich dokumentów w jednostce (obrys). 34 dokumenty pozostają bez daty.
Maksimum w 1807 roku odpowiada działalności Deputacji Administracyjnej Toruńskiej: 52 dokumenty z datą i 30 datowanych w przybliżeniu. Kruszyński pełni w niej funkcję w pierwszych miesiącach istnienia Księstwa Warszawskiego. Drugie maksimum, w 1777 roku, odpowiada sejmowi w Królewcu. Z lat 1781–1805 zachowały się nieliczne dokumenty. Seria dokumentuje działalność publiczną, która przypada na dwa krótkie okresy.
Języki
liczba stron, na których występuje dany język (strona może zawierać kilka języków)
Typy stron
klasyfikacja modelu, 672 strony
Rodzaje pisma
liczba stron, na których występuje dany rodzaj pisma. Najczęstszy jest „ołówek”, ponieważ obejmuje foliację archiwalną i dopiski archiwistów obecne na niemal każdej karcie.
Rodzaje dokumentów
98 nazw rodzajów zwróconych przez model, pogrupowanych w 14 kategorii słownika (333 dokumenty)
5. Wiarygodność odczytów
Dokładna ocena wiarygodności nie jest jeszcze możliwa. Rzeczywisty błąd odczytu (CER względem transkrypcji ręcznej) można wyznaczyć dopiero na stronach poprawionych przez paleografa; wybrano 18 stron, które oczekują na korektę. Do tego czasu dostępne są dwa wskaźniki pośrednie: zgodność dwóch niezależnych odczytów i ręczny przegląd 20 stron próbnych.
Rozbieżność odczytów według rodzaju pisma
mediana rozbieżności słów r1↔r2, strony ≥ 50 słów
Rozkład rozbieżności
530 stron, przedziały co 5 punktów procentowych
- Druk: odczyt niemal bezbłędny. Rozbieżność wynosi 1,5% dla antykwy i 4,8% dla fraktury. Różnice dotyczą głównie przenoszenia wyrazów i długiego „ſ”.
- Rękopisy: rozbieżność ok. 10–12%, bez istotnych różnic między polskim pismem kancelaryjnym, łacińskim pismem humanistycznym i kurrentą. Ręczny przegląd próbki wykazał, że polskie pismo kancelaryjne z lat 1807–1813 odczytano niemal bezbłędnie. W kurrencie z lat 1777–1778 występują pojedyncze słowa zmyślone przez model.
- Rozbieżność nie jest miarą błędu. Zawyżają ją tabele (kropki i kreski w pustych komórkach), różnice w rozwijaniu skrótów i kolejność regionów. Zaniżają ją miejsca, w których oba odczyty zawierają ten sam błąd. Rozbieżność trafnie wskazuje jednak miejsca wymagające uwagi: kolejka weryfikacji ważona rozbieżnością i długością tekstu rozpoczyna się od stron rzeczywiście wymagających korekty.
- Model rzadko sygnalizuje niepewność. Na 672 stronach oznaczył jedynie 125 niepewnych odczytów i 19 nieczytelnych fragmentów, podczas gdy różnice między odczytami są znacznie częstsze. Samoocena modelu nie zastępuje drugiego odczytu.
- Puste strony nie wywołują halucynacji. 24 puste strony przeszły przez filtr gęstości atramentu; model poprawnie sklasyfikował je jako puste.
6. Graf wiedzy: osoby, urzędy, kwoty, miejsca
Z tekstu 672 stron model wyodrębnił 6 760 wzmianek. W wyniku łączenia scalono je w 3 108 bytów, między którymi zachodzi 3 841 relacji opatrzonych cytatem i stopniem pewności. Graf jest eksportowany do formatów CSV (Neo4j), RDF (60 405 trójek w słownikach RiC-O, schema.org i PROV) oraz PAGE XML.
Byty według typu
po scaleniu wariantów
Najczęstsze relacje
12 z 30 typów
Miejsca
liczba stron ze wzmianką
Instytucje
liczba stron ze wzmianką
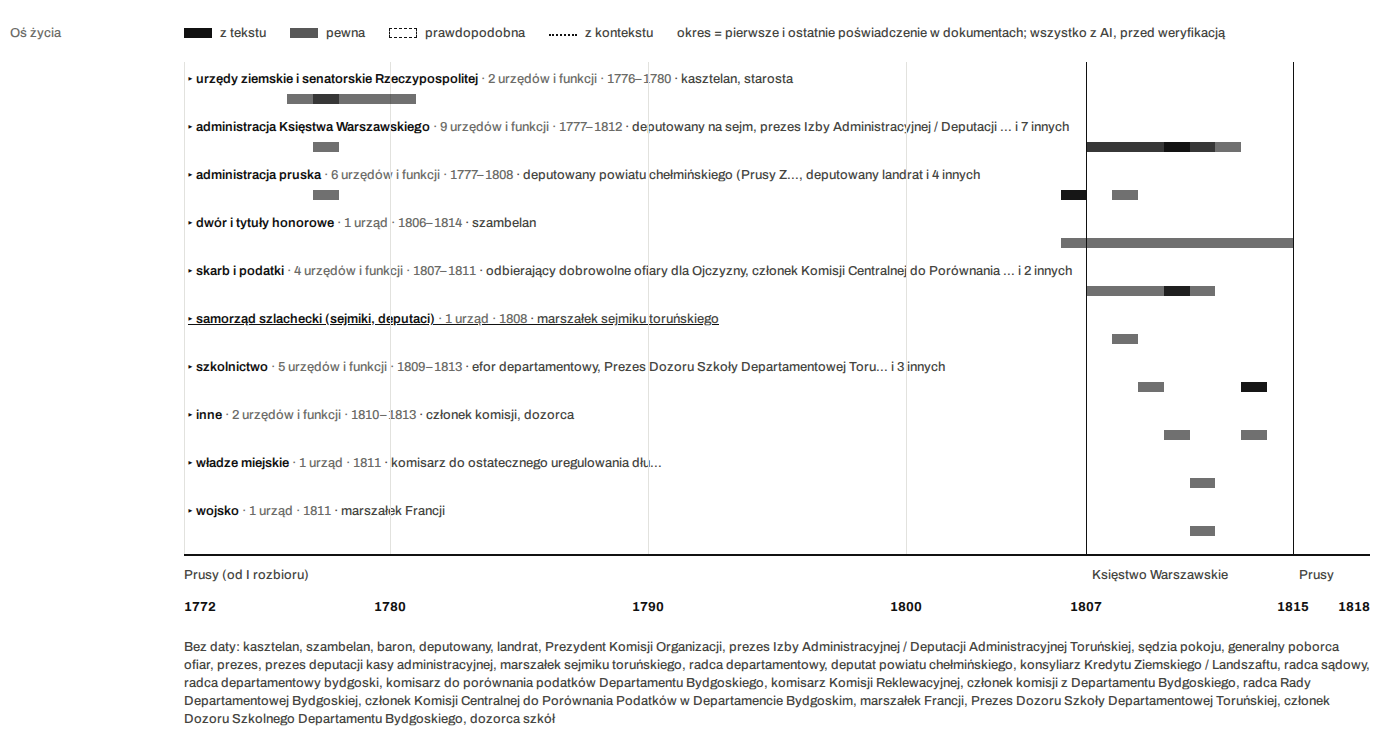
6.1. Przebieg kariery urzędniczej Kruszyńskiego
Konstanty Kruszyński występuje na 205 stronach w dziesięciu wariantach zapisu nazwiska, od „Castellan d' Krussinski” po „Cammer Herrn v Kruszinsky”. W całym zbiorze model rozpoznał 446 urzędów i funkcji. Słownik pogrupował je w pasy: urzędy Rzeczypospolitej, administracja pruska, administracja Księstwa Warszawskiego, skarb i podatki, szkolnictwo.
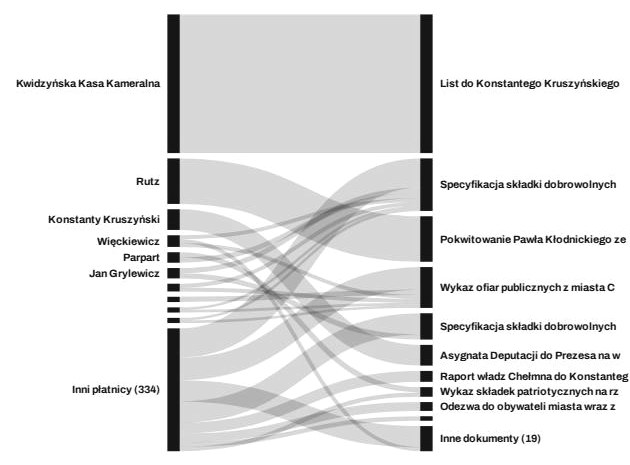
6.2. Kwoty i płatności
Model rozpoznał 783 kwoty w siedmiu walutach oraz 360 płatności z określonym płatnikiem. Kwoty zachowują brzmienie źródła („2708 rthl. 13 gl. 3 3/4 h.”) i otrzymują orientacyjną wartość w złotych (talar = 6 zł), co umożliwia ich sumowanie i wizualizację. 26 kwot zbiorczych (budżety, sumy kas państwowych) oznaczono odrębnie, aby nie zdominowały datków w wysokości 3 groszy.
Waluty
783 kwoty
6.3. Identyfikacja miejscowości
467 nazw miejscowości powiązano bez udziału modelu z dwoma rejestrami. Pierwszym jest państwowy rejestr nazw geograficznych (PRNG, ok. 124 tys. miejscowości wraz z nazwami obocznymi, także niemieckimi), drugim Wikidata. Jeżeli najlepsze kandydatury z obu źródeł leżą w odległości nie większej niż 3 km, identyfikację uznaje się za pewną.
Pasek: 467 miejscowości. Identyfikacja średnia oznacza dopasowanie w jednym źródle albo rozstrzygnięcie na podstawie współwystępujących wzmianek; 54 miejscowości niejednoznaczne i 123 bez dopasowania oczekują na ręczny przegląd wspomagany sugestiami pisowni.
Reguły dopasowania uzupełniano na podstawie analizy błędów. Wikidata proponowała m.in. Berlin w USA, wsie w Indiach i Algierii oraz „Francję” jako przysiółek. Skuteczne okazały się: odległość od Nawry, region wymieniony w opisie (ziemia chełmińska, Sambia, Podole) oraz premia dla miast w przypadku, gdy dokument wskazuje na miasto. Wszystkie 20 identyfikatorów Wikidata podanych samodzielnie przez model przeszło tę weryfikację.
7. Koszty i czas przetwarzania
Model: Gemini 3.8 Flash, ceny z września 2026 roku. Odczyty i ekstrakcję grafu wykonano przez Batch API za połowę ceny. Strony zablokowane w trybie wsadowym oraz łączenie encji przetwarzano w trybie interaktywnym.
| Etap | Żądania | Koszt | Czas |
|---|---|---|---|
| Odczyt HTR, 2 × 672 strony | 1 344 | $6,88 | tryb wsadowy, poniżej doby; ponowienie zablokowanych żądań ok. 2 h |
| Graf wiedzy z tekstu | 629 | $2,81 | tryb wsadowy, poniżej doby |
| Łączenie encji | porcje | $2,24 | tryb interaktywny, 1–2 h (przeciążenia, błąd 503) |
| razem | $11,92 | ok. $0,018 na stronę z treścią |
| Jedna strona (odczyt) | Tokeny |
|---|---|
obraz w trybie ultra_high | ≈ 2 210 |
| instrukcja | ≈ 650 |
| odpowiedź (JSON z regionami, 4 warstwy tekstu, metadane) | ≈ 2 600–2 800 |
- Tokeny wyjściowe są pięciokrotnie droższe od wejściowych, a odpowiedź jest dłuższa niż reprezentacja obrazu. Koszt zależy zatem od długości odpowiedzi i poziomu rozumowania, a nie od rozdzielczości.
- Odrzucenie pustych stron zmniejszyło liczbę wywołań o 31%. Pobranie miniatur do pomiaru zajmuje kilka minut.
- Cały zespół obejmuje ok. 42 000 stron z treścią. Przy tej samej konfiguracji koszt wyniósłby ok. $600–750 w trybie wsadowym i ok. dwukrotnie więcej bez niego. Od 2027 roku cennik ma wzrosnąć dwukrotnie.
- Próba na 20 stronach, poprzedzająca pełny przebieg, kosztowała $0,93 i umożliwiła poprawienie promptu, schematu odpowiedzi i obsługi blokad. Bez niej koszty i błędy ujawniłyby się dopiero przy 1 344 żądaniach.
8. Wyniki i ograniczenia
8.1. Wyniki
- Polskie pismo kancelaryjne przełomu XVIII i XIX wieku oraz druki: odczyty bliskie bezbłędnym, z przekładem i streszczeniem zrozumiałymi bez przygotowania paleograficznego.
- Granice dokumentów w ciągu skanów: 333 dokumenty z tytułem, rodzajem i datą.
- Datowanie: 186 dat z tekstu i 113 dat przybliżonych, wyznaczonych kodem na podstawie dokumentów sąsiednich.
- Miejsce wystawienia dla 196 dokumentów i adresat dla 139, ze wskazaniem źródła informacji (nagłówek, adres na kopercie, siedziba autora).
- Tabele z kwotami przekształcone w dane: 783 kwoty, 360 płatności z płatnikiem, przeliczenie na złote.
- Mapa niepewności wyznaczona z dwóch odczytów bez transkrypcji ręcznej oraz kolejka weryfikacji trafnie wskazująca nazwiska.
- Koszt: poniżej 2 centów amerykańskich za stronę z dwoma odczytami i grafem.
8.2. Ograniczenia i zagadnienia otwarte
- Brak rzeczywistej miary błędu; 18 stron oczekuje na korektę paleograficzną.
- Najsłabiej odczytywane są nazwiska; model upodabnia je do nazwisk znanych postaci („Kruszyński” zamiast „Gruszczyński”).
- Łączenie encji bywa nadmiernie liberalne: „Castellan von Kruszynski” z lat 70. XVIII wieku scalono z Konstantym; do grupy „Fryderyk August” włączono samo słowo „Krola”; „Kruszyńskiego Marszałka” scalono z marszałkiem Francji.
- Słownik urzędów niemal nie redukuje liczby nazw: 445 nazw daje 436 form, ponieważ są to rzeczywiście różne urzędy. Skuteczne okazało się dopiero grupowanie w pasy.
- Rodzina jest w materiale niemal nieobecna: żona Ludwika występuje na 2 stronach, matka Rozalia na jednej. Seria dotyczy działalności urzędniczej, nie spraw rodzinnych.
- Filtr bezpieczeństwa: 6,8% odczytów zablokowano bez podania przyczyny; obejście jest skuteczne, lecz wydłuża czas przetwarzania.
- Wiersze tekstu: model zwraca wyłącznie regiony, brak zatem synchronizacji wiersz po wierszu.
- Osoby nie mają identyfikatorów zewnętrznych. Wikidata ogranicza anonimowe zapytania, a pełne linkowanie osób wymaga odrębnego narzędzia.
9. Obserwacje szczegółowe
- 10 zapisównazwiska Kruszyńskiego w źródłach, w tym „Herr Cassa-Stellan Kruszinski auf Nawra”: model błędnie podzielił tytuł „Castellan” na człony „Cassa” (kasa) i „Stellan”.
- 13 wariantówzapisu Fryderyka Augusta, króla saskiego i księcia warszawskiego, od „Fred: Aug:” po „Król Jegomość Saski y Xiąże Warsza: wski”. Tyle samo wariantów ma „król Prus”.
- 52 dokumentypochodzą z jednego roku, 1807; stanowią one co szósty dokument zbioru.
- 512 stronzawiera zapisy ołówkiem, tj. foliację archiwalną. W klasyfikacji modelu jest to najczęstszy rodzaj „pisma” w zbiorze.
- 3 000 talarówreńskich: największa kwota w zbiorze, ok. 18 000 zł. Najmniejsze kwoty to datki komorników z Radoszek w wysokości 3 groszy.
- Xoznacza „ksiądz”. Drugi odczyt zachował dawny skrót, pierwszy rozwinął go do „Ks”. O tym, która wersja jest „dyplomatyczna”, decyduje instrukcja wydawnicza, nie model.
- LaTeXw transkrypcji osiemnastowiecznego protokołu:
$\underline{\text{Quaest:}}$. Model zapisał podkreślenie w notacji stosowanej w publikacjach naukowych. - „prześwitujący”zamiast „przebijający”: zmiana jednego słowa w instrukcji zmniejszyła liczbę blokad filtra.
10. Dalsze prace
10.1. Pomiar jakości odczytu
- Zbiór wzorcowy z własnego materiału. Korekta 18 wybranych stron (różne pisma, języki i typy) umożliwi obliczenie CER i WER względem transkrypcji wzorcowej, odrębnie dla każdego rodzaju pisma.
- Benchmark zewnętrzny (w toku). 263 strony z gotowymi, zatwierdzonymi transkrypcjami: polskie rękopisy z lat 1689–1828 z TranskriBUW (kronika zamojska, akta rozwodowe, Komisja Rządowa WRiOP), uwierzytelnione teksty z Wikiźródeł oraz niemiecka kurrenta z drezdeńskiego Hofdiarium; 29 dokumentów, ok. 22 ręce. Porównaniu podlega kilka modeli i dwie rozdzielczości; halucynacje (wstawienia) i pominięcia (usunięcia) są liczone osobno. Szacowany koszt: ok. $10.
- Opłacalność drugiego odczytu. Jeżeli rozbieżność r1↔r2 koreluje z rzeczywistym błędem, drugi odczyt wystarczy wykonywać wyłącznie dla rękopisów i tabel; dla druków i obwolut wystarczy jeden.
10.2. Usprawnienia metody
- Kontrola sum w tabelach i porównanie liczb między odczytami jako test automatyczny.
- Normalizacja interpunkcji i skrótów przed obliczeniem rozbieżności, tak aby kolejka weryfikacji wskazywała nazwiska, a nie kropki.
- Rozstrzyganie odczytów (ok. $10 dla tego zbioru) w miejscach, w których rozbieżność przekracza próg.
- Linkowanie osób i instytucji odrębnym, deterministycznym narzędziem, analogicznie do miejscowości.
- Segmentacja wierszy dla stron przeznaczonych do edycji naukowej.
10.3. Kolejne partie z tego samego zespołu
Kolejność ustalono według stosunku wartości do kosztu. Partie 2–4 rozbudowują sieć wokół Kruszyńskiego, zamiast tworzyć nową.
| Partia | Jednostki (69/833/0/…) | Skany | Batch | Cel |
|---|---|---|---|---|
| 2. Kruszyński: sprawy prywatne | 7.2/455–458 | 1 009 | ~$12 | rodzina, korespondencja 1777–1818, sprawy sądowe; to samo pismo co w niniejszym zbiorze |
| 3. Nawra: majątek i finanse | 2.2/63–73 bez 66, 8/540 | 898 | ~$11 | rachunki, hipoteki, testamenty, kasa ogniowa; pierwszy test starszej warstwy inwentarza |
| 4. Sumariusze | 1/1, 1/2 | 539 | ~$7 | regesty dóbr, tj. indeks do całego zespołu i źródło dat dla jednostek niedatowanych |
| 5. Następne pokolenie | 7.2/472–474, 2.2/78 | 1 277 | ~$16 | syn Józef, radca tej samej prefektury; po ocenie partii 2 |
| 2–4 razem | 2 446 | ~$30 | ok. 2,5-krotność niniejszego zbioru |
Największą luką w opisie zespołu jest 190 jednostek (19 756 skanów), którym w inwentarzu przypisano datę zastępczą „1459–1981”, tj. daty skrajne całego zespołu. Datowanie i streszczenie takich jednostek przez model stanowi mierzalną wartość dla archiwum, nawet bez pełnej transkrypcji.
11. Proponowane zbiory do dalszych zastosowań
Metoda daje najlepsze wyniki w przypadku zbiorów o trzech cechach: skany w pełnej rozdzielczości (ok. 2 000 px w krótszym boku), inwentarz z datami i tytułami umożliwiający porównanie oraz spójny krąg osób i miejsc, w którym graf się zagęszcza. Kandydaci, w kolejności od najbliższych:
| Typ zbioru | Uzasadnienie | Trudności |
|---|---|---|
| Petycje o równouprawnienie Polaków w Prusach Zachodnich, 1861 (ten sam zespół, 10.2/583 i 5.1/307) | Numerowane listy podpisów według wsi, z krzyżykami osób niepiśmiennych. Wynikiem jest łatwa do weryfikacji tabela o dużej wartości genealogicznej. 489 skanów, ok. $5. | Setki rąk; nazwiska w pisowni polskiej i niemieckiej |
| Akta administracji Księstwa Warszawskiego: prefektury, podprefektury, rady departamentowe | Te same instytucje i osoby co w grafie Kruszyńskiego; pismo kancelaryjne, które model odczytuje najlepiej | Duże jednostki, liczne kopie tych samych pism |
| Akta pruskich kamer wojenno-skarbowych i urzędów akcyzy (po 1772) | Druga strona tych samych spraw (Kwidzyn, akcyza); test odczytu kurrenty na dużą skalę | Kurrenta i formularze; większa rozbieżność odczytów |
| Inne archiwa rodzinne i majątkowe ziemiaństwa pomorskiego i kujawskiego | Ten sam typ materiału: sumariusze, inwentarze dóbr, rachunki, korespondencja; przenikające się sieci rodzin | Zróżnicowana jakość inwentarzy i skanów |
| Akta stanu cywilnego 1808–1815 | Formularze o stałym układzie; wynik można porównać z istniejącymi indeksami genealogicznymi (osoby, daty), a nie z CER | Regulaminy indeksów ograniczają masowe porównania |
| Księgi grodzkie i ziemskie, XVII–XVIII wiek | Największa wartość badawcza i największe zapotrzebowanie na odczyt | Łacina, skróty, gęste pismo; konieczne uprzednie przeprowadzenie benchmarku i rozstrzygania odczytów |
Wskazane jest również przygotowanie z tego samego zespołu niewielkiego zestawu kontrolnego z materiałów skrajnych: listów Anny Wazówny w języku szwedzkim z przełomu XVI i XVII wieku (7.4/497), sumariuszy polsko-łacińskich, niemieckich notatek archiwisty z 1919 roku i druku XVIII-wiecznego. Celem nie jest ich opracowanie, lecz wyznaczenie granic stosowalności metody.